そのプロンプト、
目次
AIを使った開発で、気づくと指示がどんどん長くなっていませんか。
「必ず詳しく考える」「絶対にすべてのファイルを確認する」「何があってもサブエージェントに分担する」。最初は失敗を減らすために付け足した指示でも、半年後に同じ指示が本当に必要かは別の話です。
そもそもAIモデル自体が更新されれば、得意な作業も指示への反応も変わります。今回は**「昔うまくいったプロンプトが、今も最適とは限らない」**という疑問を公式ガイドから調べ、どのように検証して更新すればよいかを考えます。
ここでは比較実験の設計までを紹介します。実際に旧モデルと新モデルで同じタスクを何度も走らせた結果ではありません。
プロンプトは、保存した時点で完成ではない
例えば古いモデルでは、必要なファイルを調査せずに回答したり、道具を使わずに推測で答えたりしたため、強い口調のルールを追加した経験がある人もいると思います。
でも新しいモデルが十分に自律的に調査できるようになっていたら、「必ずあらゆる場所を調べろ」という指示が、むしろ無駄なツール実行を増やすかもしれません。
Anthropicの最新モデル向けプロンプトガイドでは、モデルを移行するときに、従来の過剰なツール実行指示を緩めることや、サブエージェントを過度に使わないようにすることが案内されています。
これは「プロンプトは短ければ短いほどよい」という意味ではありません。今のモデルに必要な指示だけを残すという話です。
「あなたは優秀なエンジニアです」は意味がない?
役割指定そのものが無意味だとは言い切れません。公式ガイドでも、役割を与えて期待するスタンスや文体を明確にする方法は紹介されています。
ただし、「優秀なエンジニアとして完璧に作業して」だけでは、何が完璧なのか分かりません。
例えばバグ修正を依頼するなら、次の情報の方が成果物の評価に直結します。
何が発生しているか、どう再現するか。
変更してよい範囲、変更してはいけない箇所。
既存機能に求める互換性。
テスト方法と完了条件。
不明な前提をどう報告するか。
指示の肩書きを長くするより、目的と制約を具体的にした方が、結果を比較しやすいはずです。
比較してみたい3種類のプロンプト
同じ「入力フォームのバリデーション修正」という課題で比べるなら、次のように設計できます。
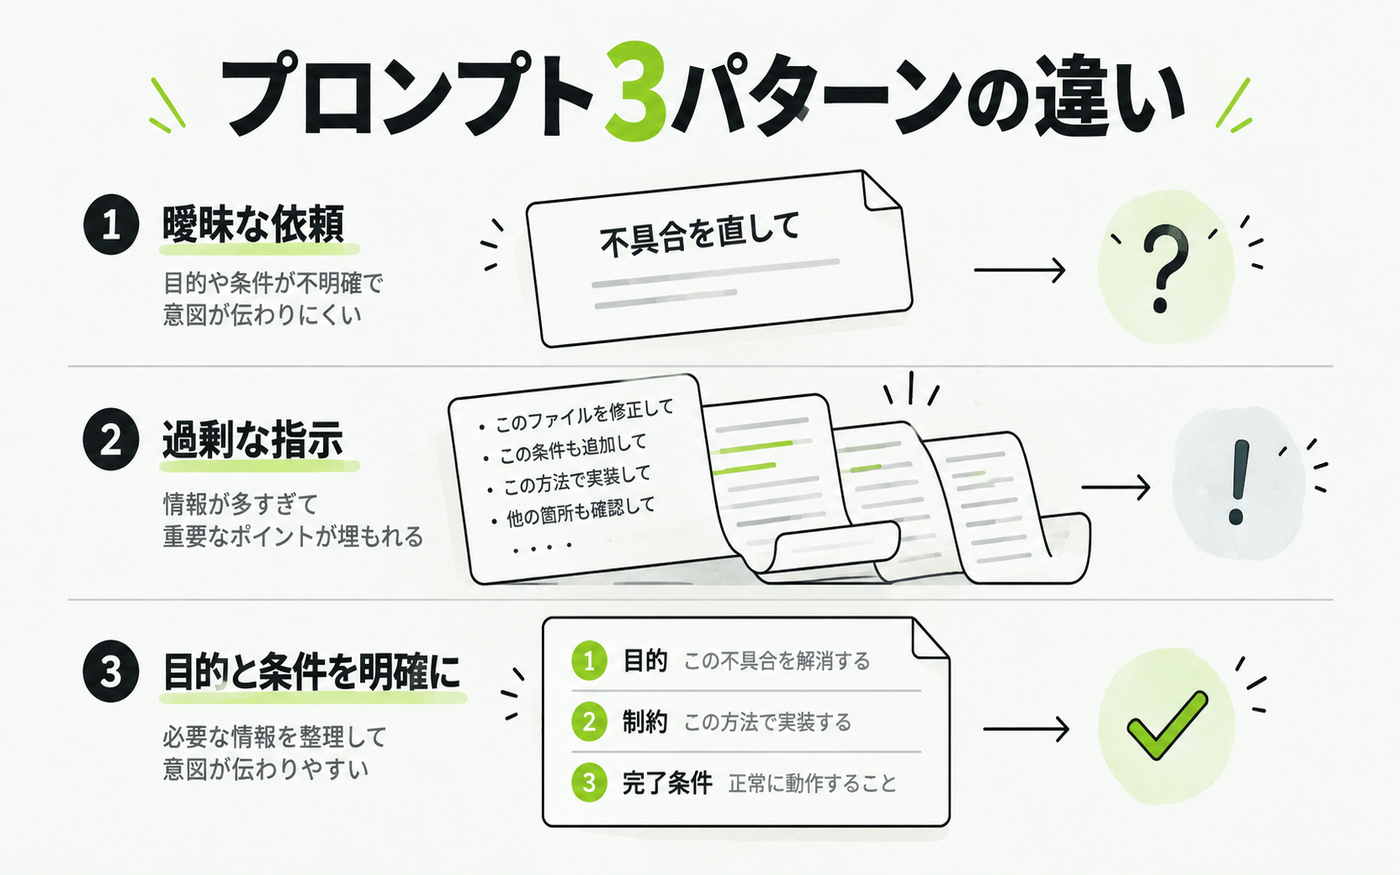
A. 曖昧な依頼
このフォームの不具合を直してください。
実務でもつい書きがちですが、期待する動作も対象も不明です。うまくいった場合でも再現性を評価しにくい。
B. 指示を大量に重ねた依頼
必ず全ファイルを調査し、すべての作業をサブエージェントに分け、入念に再確認し、できる限り多くの改善をしてください。
一見丁寧ですが、今回の修正に関係のない調査やリファクタリングまで始まる可能性があります。「たくさん考えた」「ファイルを多く触った」は品質指標ではありません。
C. 目的と完了条件を明確にした依頼
フォームの必須チェックが空欄送信で動かない問題を修正してください。対象は問い合わせフォームの検証処理です。既存の見た目とAPI仕様は変更しないでください。再現条件を確認し、最小限の修正を行い、関連テストを実行してください。実行できなかった検証は最後に明記してください。
自分なら、最初はこのCをベースにして結果を測ります。ただし、モデルによってはもっと詳細な例や、逆に簡潔な指示の方がよいこともあり得ます。
「長い・短い」より、どんな失敗を減らしたいか
プロンプトを評価するとき、文字数だけでは足りません。
観点 | 具体的な評価方法 |
|---|---|
正確性 | 要件を満たし、期待テストが通るか |
余計な変更 | 無関係なファイル、API、UIを変更していないか |
安全性 | 秘密情報や権限の境界を守るか |
自律性 | 必要な調査はするが、無駄な探索を繰り返さないか |
コスト | トークン数・実行時間・ツール実行回数 |
説明 | 何を変えたか、未確認事項が分かるか |
ここで大事なのは正解の判定条件を先に決めることです。結果を見てから「こっちの方が良さそう」と判断すると、好みや偶然に引っ張られます。
同じテストケースを複数回実行し、平均的な傾向と失敗例を見る必要があります。1回の成功だけで優劣を確定しません。
モデル更新と同時にプロンプトも変更すると、原因が分からなくなる
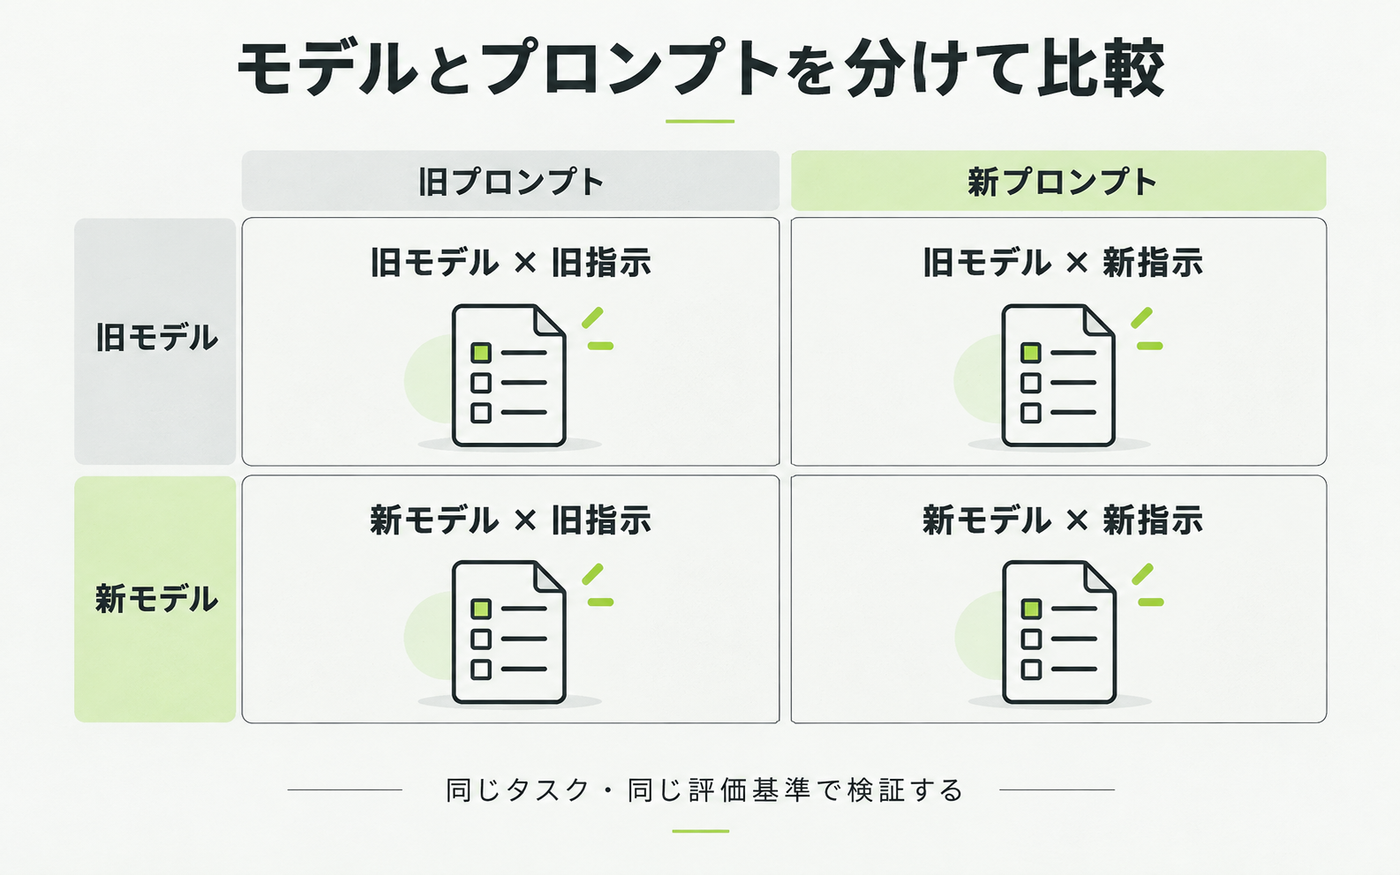
例えば、旧モデル+旧プロンプトから、新モデル+新プロンプトへ一気に移行すると、結果が良くなっても「モデルが改善したから」なのか「プロンプトが効いたから」なのか分かりません。
比較するなら、理想的には次の4条件です。
条件 | モデル | プロンプト |
|---|---|---|
1 | 旧 | 旧 |
2 | 新 | 旧 |
3 | 旧 | 新 |
4 | 新 | 新 |
もちろん旧モデルが利用できないこともあります。その場合は、同じ新モデルで旧プロンプトと新プロンプトを比べるだけでも、見直しの材料になります。
テスト時は入力、リポジトリの状態、利用可能なツール、権限、ランダム性に影響する設定をそろえたいです。AIコーディングであれば、同じGitコミットから別worktreeで実行し、結果を比較する方法も考えられます。
Claude Codeの共通ルールこそ、定期的に掃除したい
Claude Codeでは、プロジェクトや個人の設定に指示を残しておけます。便利ですが、ルールを足し続けると矛盾や重複が増えることがあります。
「なるべく自律的に進める」と「何か少しでも迷ったら必ず確認する」が一緒にあると、どちらが優先されるのか曖昧です。また「毎回すべてのテストを走らせる」は、小さなドキュメント修正では不要かもしれません。
改善するときは、指示を次の3つに分類したいです。
変わりにくい原則:秘密情報を出さない、既存仕様を尊重するなど。
プロジェクト固有の事実:ディレクトリ構成、コマンド、コード規約など。
モデル依存の小技:「必ず非常に細かく考える」など、特定の弱点を補うために追加した指示。
見直しの対象になりやすいのは3番です。とはいえ、消して悪化するかどうかは検証しないと分かりません。
ルールと参考情報を分けるだけでも違う
長いプロンプトの問題は長さだけではなく、すべてが命令になっていることかもしれません。
開発環境の情報、コード規約、タスク内容、参考資料、出力形式が一つにつながっていると、AIが何を優先すればよいか不明瞭になります。
例えば次のように分けられます。
目的:問い合わせフォームの不具合を修正する
背景:既存の仕様と再現条件
制約:APIとUIを変えない、秘密情報を扱わない
作業:調査→最小修正→関連テスト
出力:変更点、テスト結果、残る懸念
形式化そのものが目的ではありません。少なくとも、モデルに「何を守れば成功か」が分かる状態を作りたいです。
プロンプトを改善する基準は、AIの言う「良さそう」ではない
AI自身に「このプロンプトは適切ですか?」と聞けば、それらしい改善案は出せるでしょう。ただ、それだけで性能が向上した証拠にはなりません。
自分なら、実際に困ったタスクを3〜5種類用意し、旧・新の指示で比較したいです。例えば単一ファイルの修正、複数ファイルの実装、既存コードの調査、UIレビュー、テスト作成。
変更前後の成功率と余計な変更の有無を確認し、効果が出たルールだけ採用します。モデル更新のたびにすべてを書き換えるのではなく、失敗を再現できるテストを持つことが重要です。
結論:プロンプトは「完成品」ではなく、保守する設定
AIモデルが進化したからといって、これまでの指示が全部無効になるわけではありません。でも「一度作ったプロンプトは永久に最適」ということでもない。
不具合を減らすために追加した指示が、今はかえって無駄な作業を増やしているかもしれません。だからこそ、モデルを更新するときはプロンプトも点検したいと思います。
大事なのは流行のテンプレートへ乗り換えることではなく、自分の開発でどの失敗を防ぎたいのかをはっきりさせること。良いプロンプトは、長さより必要な場面で期待した結果を出せるかで判断したいです。