自動テストを入れたのに本番でコケる。
目次
自動テストを入れたのに本番でコケる。PlaywrightとHuskyを使って学んだ「確認を絞る」テスト設計
最近の開発では、HuskyやGitHub Actions、Playwrightを使って、できるだけ確認作業を自動化することが増えました。
手でブラウザを開いて、 フォームを送って、 画面を移動して、 表示が崩れていないか見て、 また別のページを確認する。
こういう作業は、E2Eテストを入れるとかなり減らせます。
実際、以前より確認作業はかなり楽になりました。
ただ、それでも普通にあります。
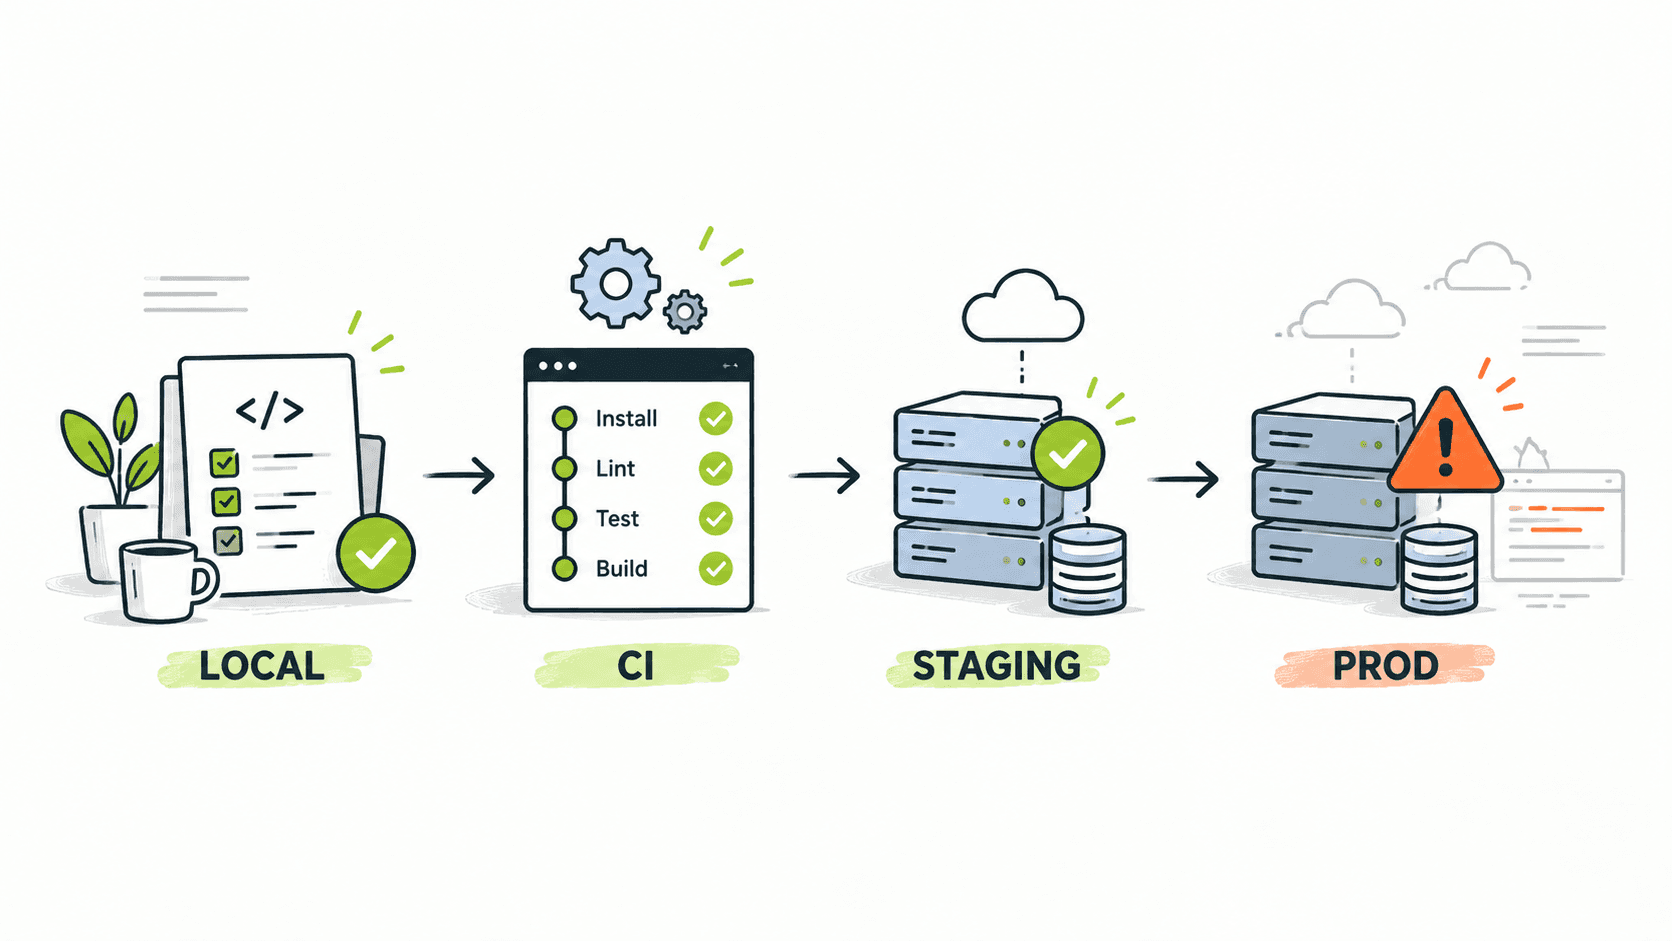
ローカルでは通った。CIも通った。なのにステージングや本番でコケる。
時間があるときなら原因を追えばいいのですが、リリース前や急いでいるときに出るとかなり困ります。
そこで最近は、
「自動テストを増やせば安心」ではなく、どの段階で何を確認するかを絞る方が大事なのでは?
と考えるようになりました。
この記事では、Husky・GitHub Actions・Playwrightの役割を整理しながら、自動化しても環境ごとの確認がなくならない理由と、確認範囲をどう絞るかを考えます。
まず3つの役割を分ける。HuskyがGitHub Actionsを動かしているわけではない
Husky、GitHub Actions、Playwrightを一緒に使っていると、全部まとめて「自動テストの仕組み」に見えます。
でも役割はかなり違います。
Huskyは、自分のPCでGit操作の前後にチェックを入れる
HuskyはGit hooksを扱いやすくするツールです。
公式では、commitやpushのタイミングでlintやテストなどを実行できるツールとして紹介されています。
参考: https://typicode.github.io/husky/(外部サイト)
たとえばpre-commitで、
ESLint
Prettier
TypeScriptの型チェック
軽いテスト
などを走らせておけば、
明らかに壊れているコードをcommitする前に止める
という使い方ができます。
pre-pushで少し重いチェックを入れることもできます。
ただし、ここで重要なのは、
Huskyは基本的にローカル側のGit hookです。
GitHub Actionsを直接起動する仕組みではありません。
GitHub ActionsはpushやPRを受けてCI側でチェックする
GitHub Actionsは、GitHub上のイベントをきっかけにworkflowを実行できます。
たとえば、
push
pull_request
workflow_dispatch
などです。
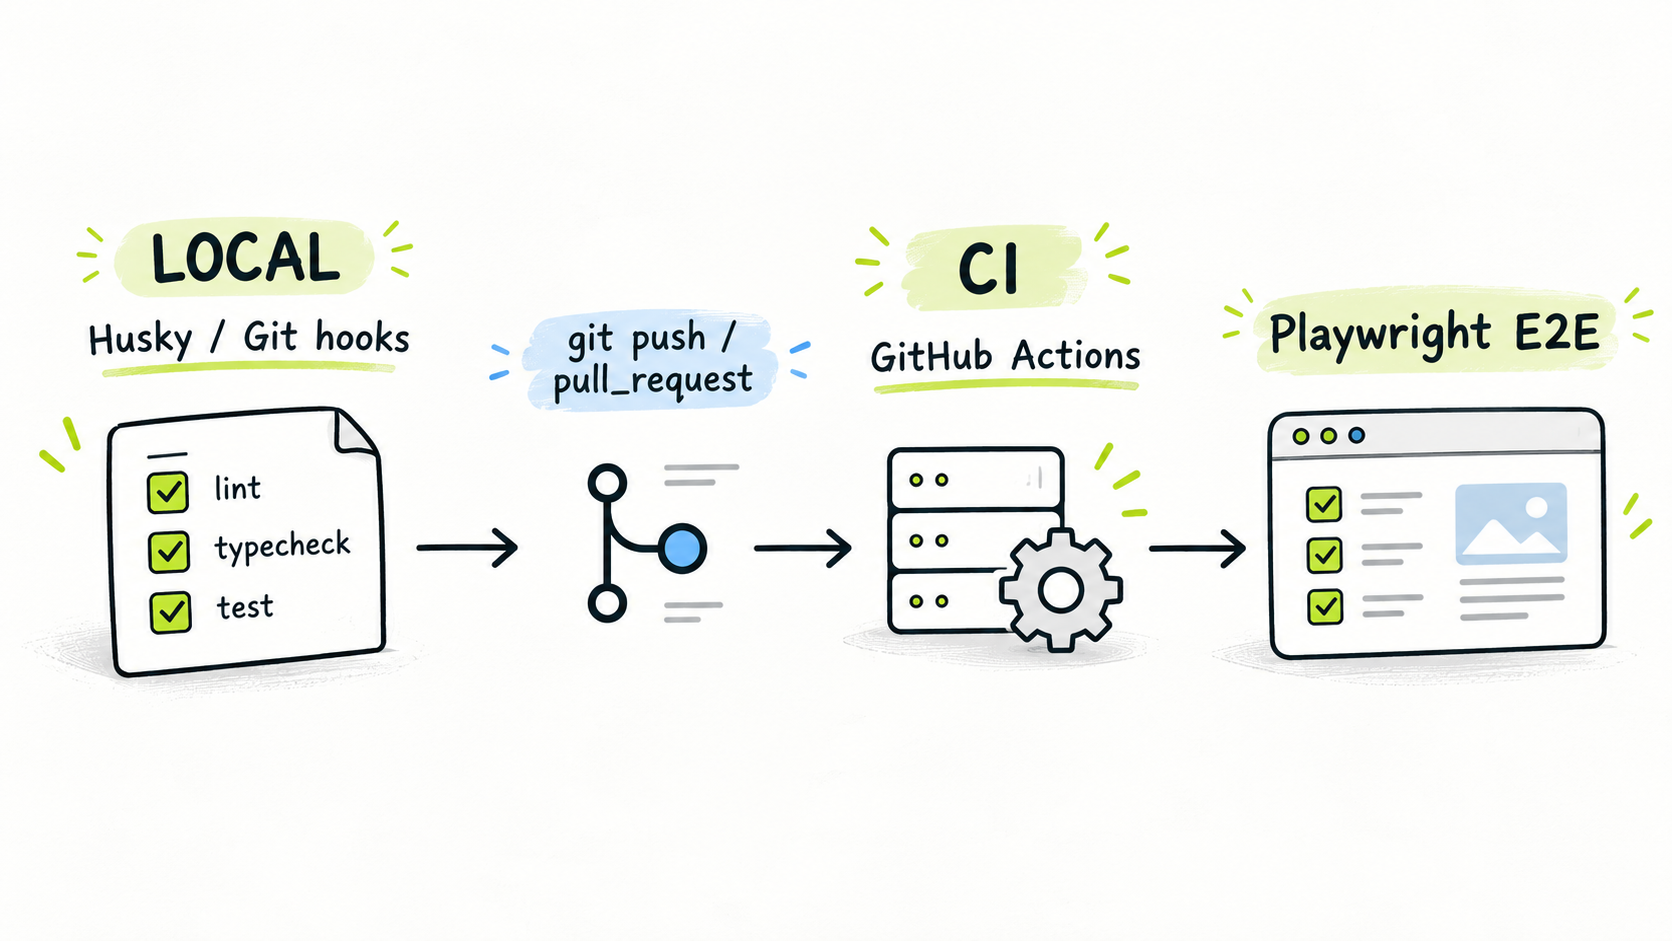
つまり流れとしては、
ローカルでHuskyのチェック
→ push
→ GitHub側でpush / pull_requestイベント発生
→ GitHub Actionsが動く
という形です。
感覚的には全部つながっていますが、役割は別です。
ローカルのHuskyを無効にしてpushしたとしても、GitHub Actions側のworkflowが設定されていればCIは動かせます。
逆にHuskyで全部通っても、CI環境で同じ結果になるとは限りません。
ここが、後で「ローカルでは通ったのに」に繋がってきます。
Playwrightは「実際にユーザーが触る流れ」を自動化できる
Playwrightはブラウザを操作してテストできるツールです。
公式Docsでは、Chromium・WebKit・Firefoxなどを使ってテストを実行でき、CLIから特定テストや複数ブラウザでのテストを実行できます。
参考: https://playwright.dev/docs/running-tests(外部サイト)
たとえば、
import { test, expect } from '@playwright/test';

test('ログインしてマイページを表示できる', async ({ page }) => {
  await page.goto('/login');
  await page.getByLabel('メールアドレス').fill('test@example.com');
  await page.getByLabel('パスワード').fill('password');
  await page.getByRole('button', { name: 'ログイン' }).click();

  await expect(page.getByRole('heading', { name: 'マイページ' })).toBeVisible();
});
のように、
ページを開く
→ 入力する
→ ボタンを押す
→ 遷移する
→ 結果を確認する
というユーザー操作を自動化できます。
これが本当に便利です。
フォームやログイン、購入導線のように、毎回人間が確認すると面倒な部分ほど効果があります。
Playwrightには失敗したテストを再実行するretryもあります。
参考: https://playwright.dev/docs/test-retries(外部サイト)
ただし、retryを増やせば不安定なテストが解決するわけではありません。
「1回目は落ちたけど2回目は通った」を見つける材料にはなりますが、原因そのものは別にあります。
ここまで自動化しても、なぜ本番でコケるのか
ここが一番困るところです。
ローカルでHuskyを通した。
GitHub Actionsも成功した。
PlaywrightのE2Eも通った。
それでもステージングや本番だけでエラーが出ることがあります。
これは、自動テストが役に立っていないわけではありません。
テストした環境と、本番環境が完全に同じではないからです。
たとえば環境ごとに、次のような差があります。
環境変数が違う
ローカルでは、
API_URL=http://localhost:3000だったのに、本番では別URLになります。
APIキーや外部サービスの設定も違います。
値がない。 名前を間違えた。 公開してはいけない変数をフロントから使っている。
こうした問題は、コード自体が同じでも本番でだけ発生します。
データが違う
ローカルやテスト環境ではきれいなfixtureデータを使えても、本番には実際のデータがあります。
想定より長い文字列。 NULL。 古いデータ。 特殊な状態。
テストデータだけでは出なかったケースが、本番で初めて出ることがあります。
外部サービスが違う
メール送信、決済、ストレージ、認証APIなど、外部サービスを使うとさらに差分が増えます。
ローカルではモック。 ステージングではテスト環境。 本番では本物。
ここが同じ挙動になるとは限りません。
ビルドや配信の条件が違う
ローカルの開発サーバーでは動くけど、本番ビルドでは動かない。
キャッシュが残っている。 CDN経由で挙動が違う。 アクセス権が違う。 Node.jsなどの実行環境が違う。
「コードのテスト」と「デプロイされた環境の確認」は、完全には同じではありません。
全部を毎回確認しようとすると、今度はリリースできなくなる
本番でしか出ない問題がある。
となると、
じゃあ全部の機能をローカル、CI、ステージング、本番で毎回確認すればいい
となりそうです。
でも現実にはかなり重いです。
機能が増えるほどテスト時間も増えます。
E2Eはブラウザを実際に動かすので、軽い静的解析やunit testより時間がかかります。
さらに本番でユーザー操作を再現するテストは、内容によってはデータを書き換えたりメールを飛ばしたりするため、安全に実行できないケースもあります。
なので最近は、
「どこまで自動化できるか」より「どこで何を確認するか」を決める方が重要
だと思っています。
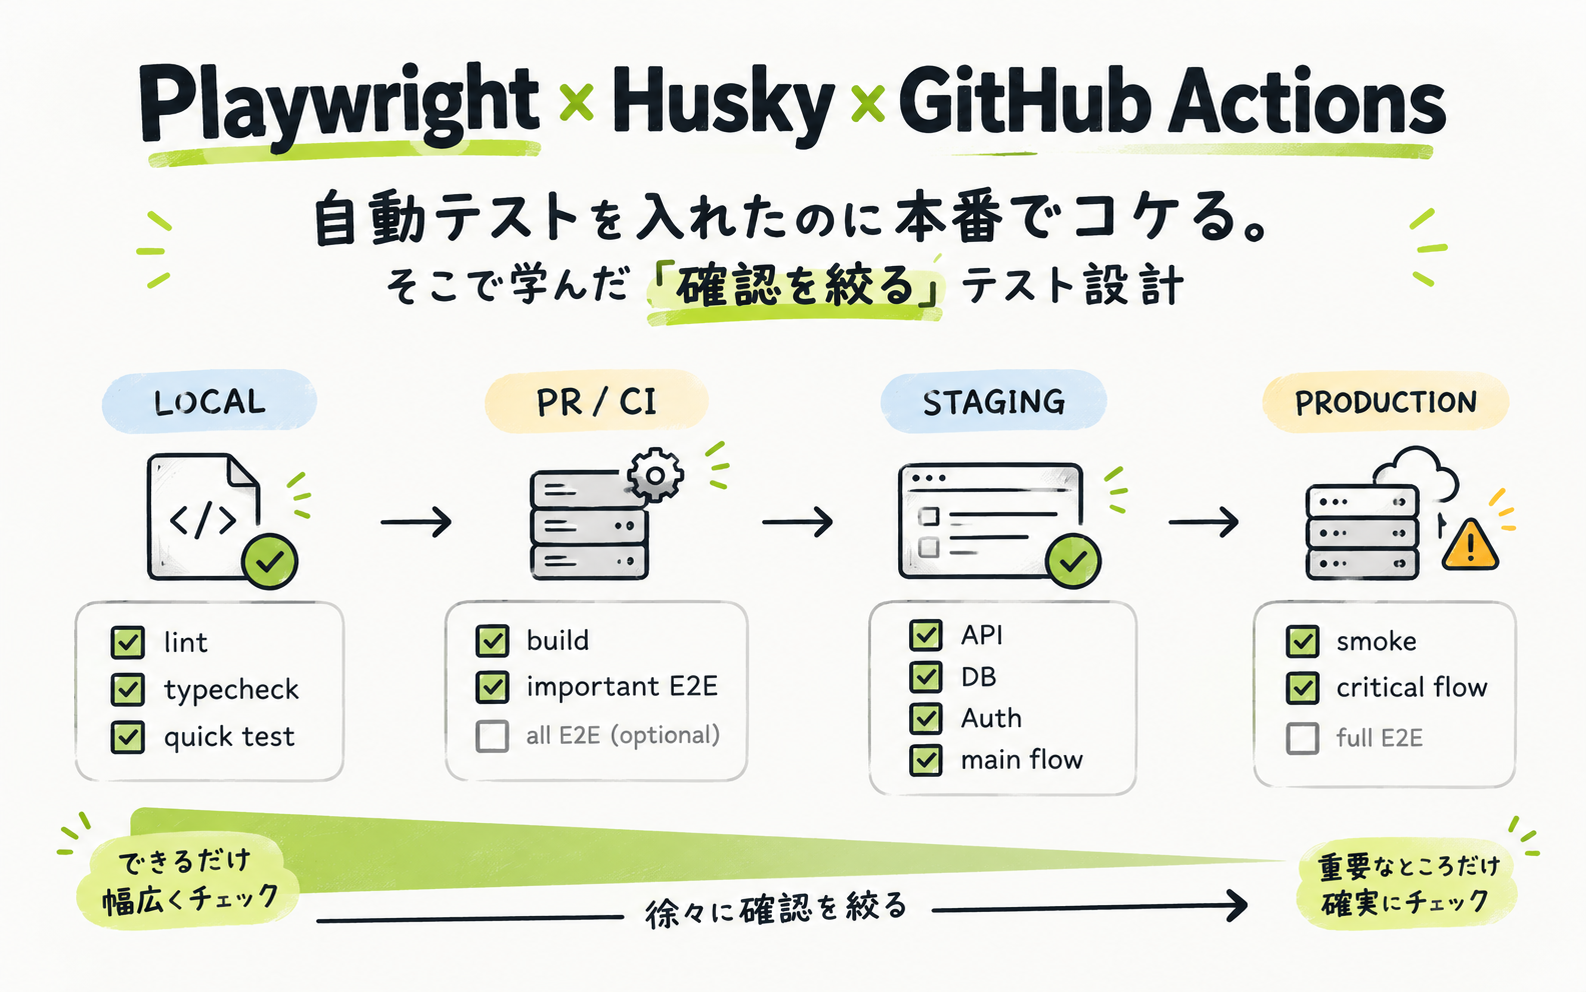
自分なら、確認を4段階に分ける
今のところ、全部の段階で同じテストを回すより、
ローカル
→ PR / CI
→ ステージング
→ 本番
で役割を分けるのが分かりやすいと感じています。
1. ローカル:速く落とせるものを先に落とす
Huskyで毎回何分もかかるE2Eを全部実行すると、commit自体が重くなります。
なのでローカルでは、
lint
format
type check
変更箇所に近い軽いテスト
など、速く失敗を見つけられるものを中心にします。
狙いは、
CIに送る前に、明らかなミスを消す
ことです。
2. PR / CI:アプリとして壊れていないか確認する
pushやpull requestでは、GitHub Actions側で、
install
lint
type check
build
unit / integration test
重要なPlaywright E2E
などを実行します。
ここでは、
mainへ入れても大丈夫そうか
を見るイメージです。
PlaywrightのE2Eも、全画面を細かく確認するより、
ログインできる
フォームを送信できる
主要ページを移動できる
といった壊れたら困る導線を優先します。
ステージングでは「環境がつながっているか」を見る
CIを通過したら、次はステージングです。
ここではコードそのものだけではなく、
実際のデプロイ環境で各サービスが正しくつながっているか
を確認します。
たとえば、
APIへ接続できるか
DBへ接続できるか
環境変数が正しいか
認証できるか
ストレージへアクセスできるか
リダイレクトがおかしくないか
本番に近いビルドで主要導線が動くか
などです。
PlaywrightはbaseURLを設定できるので、設定を分ければローカルとは別のURLを対象にテストできます。
参考: https://playwright.dev/docs/test-webserver(外部サイト)
ただし、環境ごとにデータや外部依存が違うため、
ローカルとまったく同じE2Eをそのまま流せば十分
とは限りません。
ステージングでは、「環境依存で壊れやすいところ」を意識した方が効きます。
本番では「全部」より、壊れたら致命的なところを見る
本番確認が一番難しいです。
本番だから全部確認したくなります。
でも、毎回すべての画面・操作を人間が確認するなら、自動化した意味がかなり薄くなります。
逆に、E2Eで本番データを好き放題書き換えるのも危険です。
そこで本番では、
最低限のスモークテスト
に絞る考え方がかなり使いやすいです。
たとえば、
トップページが表示される
ログイン画面が表示される
主要APIが正常応答する
重要ページへ遷移できる
読み取りだけで確認できる主要機能が動く
などです。
フォーム送信や決済のように副作用が大きい機能は、専用のテストデータ・テストアカウント・安全な確認方法が用意されていないなら、本番E2Eに無理やり入れない方がいいケースもあります。
大事なのは、
全部確認したかではなく、今回壊れると困るものを確認できたか
です。
「確認を絞る」は、テストを減らすという意味ではない
最初は、
テストをたくさん書けば、確認作業はどんどんなくせる
と思いがちです。
実際、かなり減らせます。
自分もPlaywrightを使うようになって、毎回同じ操作を人間が繰り返す量は減りました。
でも、テストが増えるほど、
実行時間
flaky testの対応
テストデータ管理
CIコスト
メンテナンス
も増えます。
だから「確認を絞る」というのは、
テストを適当に減らすことではありません。
どの失敗を、どの段階で捕まえるかを決めること
です。
たとえば、
lintで分かることをE2Eで確認しない。
CIで確認できることを毎回人間が触らない。
ステージングで確認すべき接続問題をローカルだけで安心しない。
本番では重要導線に絞る。
こうすると、それぞれのテストの意味がかなり分かりやすくなります。
テストが落ちたときも「どの段階か」を見ると切り分けやすい
この考え方は、失敗したときにも便利です。
ローカルだけ落ちる
PC側の環境、Node.jsのバージョン、依存関係、ローカル設定などを疑う。
CIだけ落ちる
GitHub Actionsのrunner、Secrets、install方法、ビルド設定、CI専用設定などを見る。
ステージングだけ落ちる
環境変数、API、DB、認証、ネットワーク、外部サービスなど、デプロイ後の接続を疑う。
本番だけ落ちる
本番固有のデータ・権限・キャッシュ・インフラ設定・外部サービスなどを見る。
もちろん原因が必ずこの分類通りになるわけではありません。
でも、
どこまでは通っていたか
が分かるだけで、闇雲に全部見るよりかなり切り分けやすくなります。
自動テストの目的は「人間が一切確認しなくていい状態」ではなかった
Husky、GitHub Actions、Playwrightを使うと、確認作業はかなり自動化できます。
これは間違いなく便利です。
ただ、実際にローカルからステージング、本番まで通していると、
全部自動化したから安心
とはなりませんでした。
環境が変われば、データも設定も外部サービスも変わります。
だから今は、
Huskyで早く落とす
→ GitHub Actionsでコード全体を確認する
→ Playwrightで重要導線を自動確認する
→ ステージングで環境差分を見る
→ 本番は致命的な箇所に絞って確認する
くらいの分担が分かりやすいと思っています。
自動テストは、確認をゼロにする仕組みではありません。
人間が確認する場所を、本当に必要なところまで減らす仕組み。
そのくらいに考えると、PlaywrightもHuskyもGitHub Actionsもかなり使いやすくなりました。